Die Expertise kartieren.
Dann erfassen, was sie weiß.
Peer-validiertes Kompetenznetzwerk + KI-gestützte Expertenbefragungen + dreistufige Extraktions-Pipeline + semantischer Vergleich über Experten hinweg. Knowledge Mapping ist die institutionelle Gedächtnisebene: Sie erfasst, wer was weiß und wie es tatsächlich umgesetzt wird, und gleicht das organisationsweit ab, wobei jede Entscheidung reversibel bleibt.
Wer was weiß, validiert, bevor die Dokumentation beginnt.
Das System beginnt mit der Kompetenzkarte, nicht mit dem Dokument. Selbst-Nominierungen und Manager-Nominierungen durchlaufen ein Peer-Validierungsnetzwerk mit vier Verdikten. Nur validierte Kompetenzen lösen eine Expertenbefragung aus.
- Validierung mit fünf Verdikten: Bestätigt · Widerspruch · Nicht vertraut · “Anche Io” (habe ich auch) · “Shared Others” (eine Kollegin oder einen Kollegen nominieren). Die Struktur des Netzwerks bildet geteilte Expertise ab, ganz ohne Befragung.
- Schwellenwertbasierte Promotion: Kandidat → validierte Erfahrung erst nach konfigurierbarer Anzahl an Bestätigungen. Keine Expertenbefragung wird verschwendet für eine Behauptung, die Peers ablehnen.
- Cross-Pollination über „Anche Io“: Wenn ein Peer signalisiert, die Kompetenz ebenfalls zu besitzen, stößt das System parallel eine Expertenbefragung an und erfasst so Varianten desselben Prozesses aus mehreren Quellen.
- Scope-bewusste Verteilung: Validierungsanfragen werden nach Organisationseinheit, Projekt oder global geroutet. Peers werden nach fachlicher Nähe gewählt, nicht nach Nähe im Organigramm.
Implizites Wissen, von einer dialogorientierten KI extrahiert, ohne Formular zum Ausfüllen.
Sobald eine Kompetenz validiert ist, lädt das System den Experten zu einem adaptiven Chat ein. Der Interview-Agent entscheidet, was vertieft wird und wann der Prozess mit allen kritischen Details erfasst ist, ohne feste Länge und ohne festes Skript.
- Adaptive Fragestellung: Der Agent liest jede Antwort und wählt die nächste Frage. Er vertieft Spezifika (Namen, Kanäle, Timing) dort, wo die Antwort vage bleibt.
- Vollständigkeitserkennung: Der Agent entscheidet, wann der Prozess die Schritte, Stakeholder, Tools und das Timing enthält, die für die nachgelagerte Extraktion nötig sind, und nicht früher.
- Echtzeit-Streaming: SSE-basierte Session, vollständige Konversationshistorie persistiert, sitzungsübergreifend wiederherstellbar.
- Kontextsensitiv: Der Agent erhält die Rolle des Experten, Organisation, Projekt und den Kompetenzkontext, nicht ein leeres Blatt.
- Mehrsprachige Erfassung: Expertenbefragungen in der bevorzugten Sprache des Beitragenden; nachgelagertes Retrieval funktioniert sprachübergreifend.
Drei Phasen. Konversation rein, strukturiertes Wissen raus.
Jede abgeschlossene Befragung durchläuft sequenziell drei spezialisierte LLM-Agenten, als Celery-Tasks orchestriert, damit die UI nie blockiert. Output ist ein strukturierter Prozess mit Schritten, Stakeholdern, Tools, Timing und einem Completeness Score.
- Phase 1 · Neuordnung: Der Reordering Agent schreibt den Chat in ein chronologisches Narrativ um und entfernt Smalltalk und Meta-Talk. Output: ein sauberer linearer Text, den die nächste Phase deterministisch parsen kann.
- Phase 2 · Extraktion: Der Extraction Agent emittiert strukturierte Daten: Prozessname, Beschreibung, geordnete Schritte, Stakeholder (Name, Rolle, Kommunikationskanal, Timing), Tools, Gesamtzeitachse.
- Phase 3 · Validierung: Der Validation Agent berechnet einen Completeness Score zwischen 0 und 1 und markiert nur kritische Lücken (externe Stakeholder, kritische Tools, Timing für High-Impact-Schritte). Unterhalb von 0,75 wird die Befragung zum Follow-up markiert.
- Intelligente Noise-Filterung: Tools wie “discuss” oder “review” werden nicht markiert. Interne team-Kontakte werden nicht markiert. Nur wesentliche Lücken treten zutage.
- Audit Trail: Jeder LLM-Aufruf wird protokolliert (Modell, Prompt, Response, Tokens) für die Compliance-Prüfung.
Wenn zwei Experten denselben Prozess dokumentieren, gleicht das System sie ab.
Sobald zwei oder mehr Experten Prozesse im selben Kontext dokumentiert haben, läuft automatisch ein semantischer Vergleichsagent. Er identifiziert geteilte Schritte, einzigartige Beiträge und Konflikte und routet das Ergebnis dann durch eine dreistufige Entscheidungslogik.
- Ähnlichkeit > 0,95: Erzeugt einen Manager-Approval-Request. Ein Merge erfolgt nie automatisch; der Vergleich geht an den Campaign Creator mit geteilten/einzigartigen Schritten und der Begründung des Agenten. Der Manager genehmigt einen Shared Process oder belässt sie getrennt.
- Ähnlichkeit 0,4–0,95: Als Partial Match markiert. Beide Prozesse koexistieren; der Kontext wird für ein inkrementelles Review getaggt.
- Ähnlichkeit < 0,4: Für Human Review markiert. Die beiden Experten beschreiben wahrscheinlich verschiedene Prozesse, die zufällig dasselbe Kompetenz-Label teilen.
- Reasoning mit realen Namen: Der Vergleichsbericht verwendet die tatsächlichen Expertennamen (“Marcos Eskalationsschritt” statt “Expert 1”) und macht Entscheidungen über die gesamte Führungslinie hinweg nachvollziehbar.
- Konflikte sichtbar machen: Wo sich Schritte widersprechen (Marco sagt “via Slack eskalieren”, Sofia sagt “per E-Mail”), markiert der Agent den Konflikt, statt stillschweigend eine Variante auszuwählen.
- GETEILT Secondary On-Call über PagerDuty pagen, wenn Primary nicht innerhalb von 5 Min. ack-t
- MARCO Über #incident-eng in Slack direkt an den EM eskalieren, nicht per E-Mail
- GETEILT In StatusPage innerhalb von 10 Min. nach Erkennung acknowledgen
- SOFIA Channel #cust-XYZ-incident für Kunden im Enterprise-Tier eröffnen
Eine durchsuchbare Knowledge Base, mit einem Undo-Button bei jeder Entscheidung.
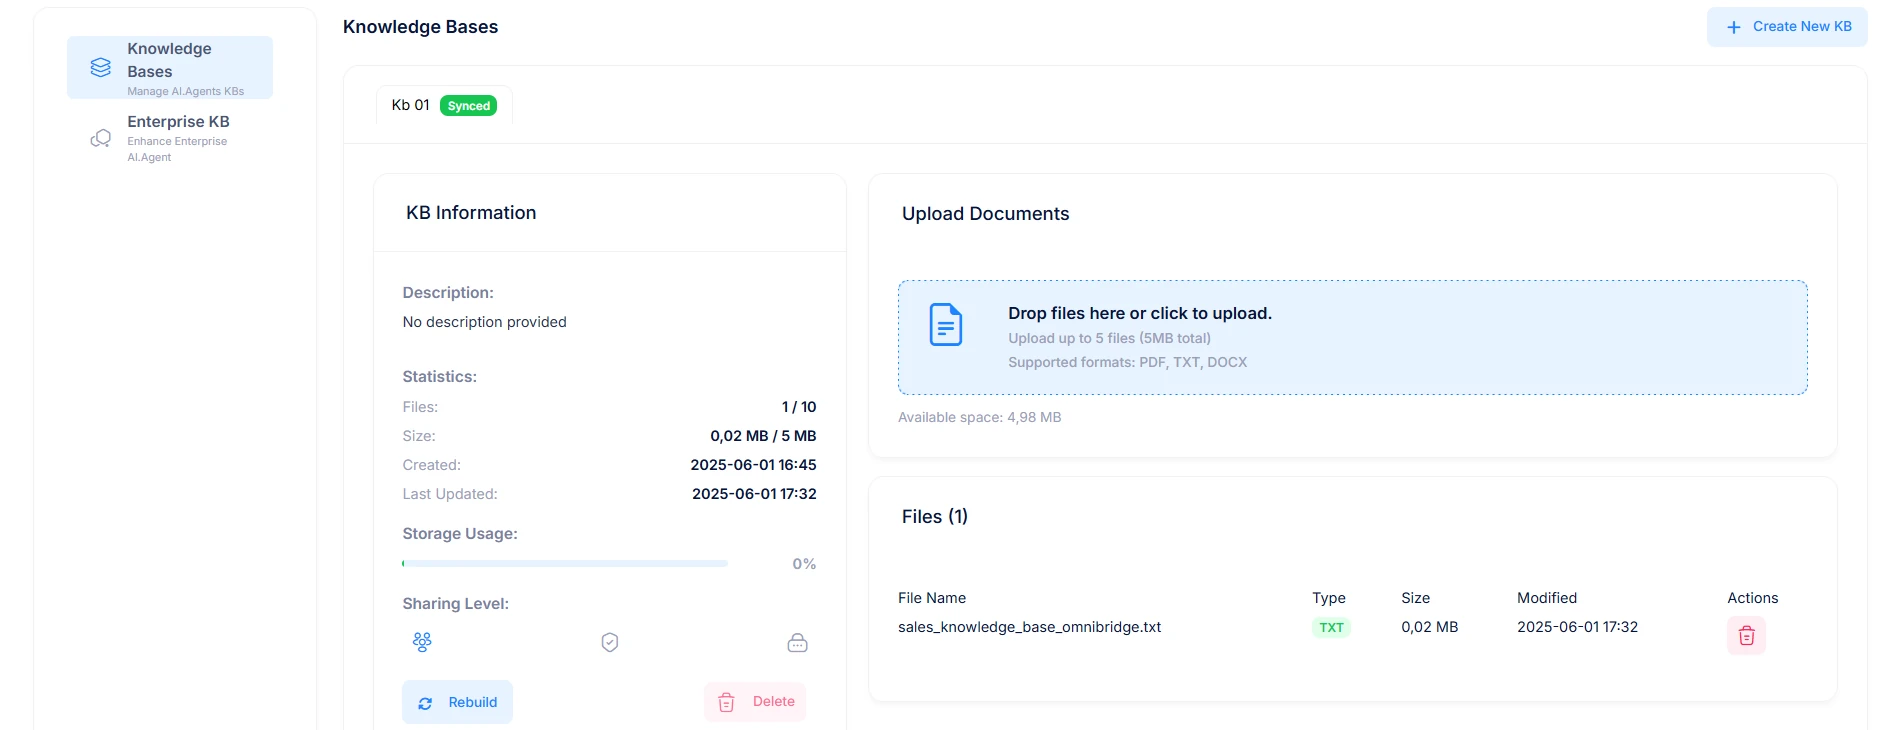
Der Output ist eine Knowledge Base dokumentierter Prozesse: durchsuchbar, filterbar, mit Drill-Down auf chronologisches Narrativ + Stakeholder + Tools + Timing. Jede Operation ist Soft Delete: Der Audit Trail überlebt jeden Merge, jedes Undo, jeden Refresh.
- Serverseitige DataTables: Schnelle Suche und Filterung auch bei Tausenden dokumentierter Prozesse. Drill von der Zeile zur vollständigen Prozessansicht.
- Completeness Score pro Prozess sichtbar: Score zwischen 0 und 1 aus der Phase-3-Validierung, mit der Liste fehlender Informationen. Wissenslücken sind explizit, nicht versteckt.
- Reversible Merges: Ein manager-freigegebener Merge lässt sich per Klick rückgängig machen. Originalprozesse werden wiederhergestellt, der Shared Process archiviert, der Audit Trail auf beiden Seiten erhalten.
- Soft Delete auf allem: Archivierte Daten bleiben für Audits abfragbar (DSGVO Artikel 30, ISO-27001-Evidenz). Restore ist ein Statuswechsel, kein Backup-Recovery.
- Dreistufiges Zugriffsmodell: Owner / App Manager / Campaign Creator sehen die vollständige Pipeline; reguläre Benutzer sehen nur ihren Overview-Bereich und ihre offenen Aufgaben (Validierungen, Expertenbefragungen, Freigaben).
Das erfasste Wissen speist jeden Agenten auf der Plattform.
Knowledge Mapping ist die Quelle, nicht das Ziel. Die validierte, dokumentierte, deduplizierte Wissensbasis wird zur Abrufgrundlage für den Rest der Plattform: Chatbots, Onboarding-Agenten, strategische Analysten.
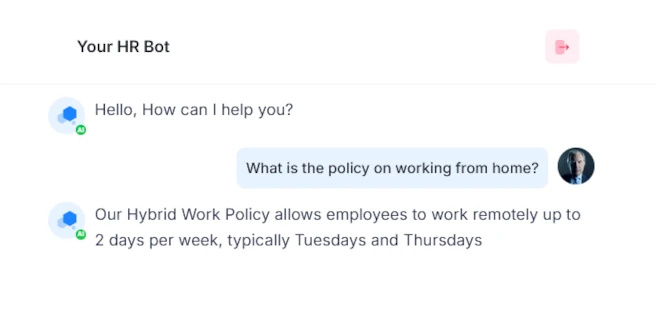
- Chatbot Assistants verweisen zurück auf die ursprüngliche Expertenbefragung, in der die Antwort erfasst wurde.
- Onboarding-Agenten beantworten Fragen von Neueinsteigern aus validierten Prozessen statt aus generischen FAQs.
- Interne Übergaben übergeben dem neuen Owner ein strukturiertes Briefing, nicht einen Loom-Link.
- Need-to-know-Geltungsbereich für jedes Asset. Jedes erfasste Asset trägt einen Vertraulichkeitsbereich (Organisationseinheit, Projekt oder privat für den Autor), sodass der Abruf auf die dazu berechtigten Personen beschränkt werden kann.
- Right-to-Delete auf Expertenebene umgesetzt: Ein Löschantrag führt zu einem Soft Delete der Beiträge; der gemergte Prozess bleibt bestehen, wobei die identifizierbaren Beiträge des Experten aus dem Trail entfernt werden, und das Löschereignis wird protokolliert.
Wo sich Knowledge Mapping auszahlt.
- Erhalt kritischen Wissens
- Ruhestands- und Nachfolgerisiko
- Erfassung des Gründer-Wissens
- Audit von Single Points of Failure
- Operative Resilienz
- Prozessstandardisierung (Multi-Site)
- Identifikation von Best Practices
- Abgleich von Varianten teamübergreifend
- M&A-Wissensintegration
- Customer-Escalation-Playbook
- Knowledge Base für das Onboarding neuer Mitarbeiter
- Incident-Response-Runbook
- Strukturierte Mentoring-Programme
- Lessons aus gescheiterten Projekten
- Vierteljährlicher Refresh-Zyklus
