Mappa le competenze.
Poi acquisiscine il know-how.
Network di competenze validato tra pari + interviste AI agli esperti + pipeline di estrazione a tre fasi + confronto semantico tra esperti. Il Knowledge Mapping è il livello di memoria istituzionale che cattura chi sa cosa e come lo fa davvero, riconciliandolo in tutta l'organizzazione, con ogni decisione reversibile.
Chi sa cosa, validato prima ancora di iniziare a documentare.
Il processo parte dalla mappa delle competenze, non dai documenti. Le autocandidature e le nomine dei manager passano attraverso un network di validazione peer-to-peer a quattro livelli. Solo le competenze validate sbloccano l'intervista all'esperto.
- Validazione a cinque verdetti: Confermato · Non d'accordo · Non lo conosco · “Anche Io” · “Shared Others” (segnala un collega). La forma del network mappa le competenze condivise senza bisogno di un sondaggio.
- Promozione basata su soglie: da candidato a esperto validato solo dopo un numero di conferme personalizzabile. Nessuna intervista sprecata per competenze non riconosciute dai colleghi.
- Scambio di conoscenze tramite l'opzione Anche Io: quando un collega segnala di possedere la stessa competenza, il sistema genera un'intervista all'esperto in parallelo, catturando le varianti dello stesso processo da più fonti.
- Distribuzione basata sull'ambito: richieste di validazione instradate per elemento organizzativo, progetto o a livello globale: i colleghi vengono scelti per affinità di competenza, non per vicinanza nell'organigramma.
Know-how tacito estratto da un'AI conversazionale, senza moduli da compilare.
Una volta validata la competenza, il sistema invita l'esperto a una chat adattiva. L'agente che conduce l'intervista decide cosa approfondire e quando il processo è stato catturato in tutti i suoi dettagli critici: nessuna durata fissa, nessun copione prestabilito.
- Domande adattive: l'agente legge ogni risposta e sceglie la domanda successiva, approfondendo i dettagli (nomi, canali, tempistiche) dove la risposta è vaga.
- Rilevamento del completamento: l'agente stabilisce quando il processo include i passaggi, gli stakeholder, gli strumenti e le tempistiche necessari per l'estrazione successiva, e non prima.
- Streaming in tempo reale: Sessione basata su SSE, storico completo delle conversazioni mantenuto e recuperabile tra le sessioni.
- Sensibile al contesto: l'agente riceve il ruolo dell'esperto, l'organizzazione, il progetto e il contesto della competenza, non parte da zero.
- Acquisizione multilingue: interviste esperte nella lingua preferita del collaboratore; il recupero a valle opera senza vincoli linguistici.
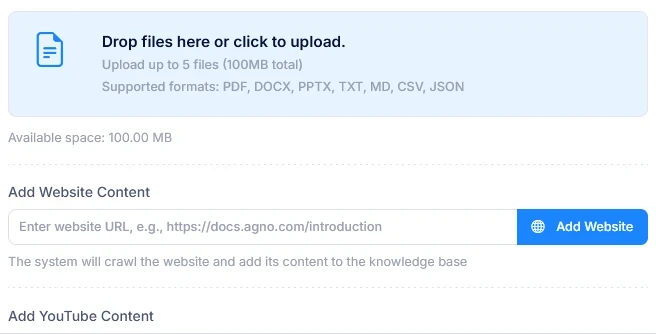
Tre fasi. Conversazione in entrata, conoscenza strutturata in uscita.
Ogni intervista completata attraversa in sequenza tre agenti LLM specializzati, orchestrati come task Celery in modo che l'interfaccia non si blocchi mai. Il risultato è un Processo strutturato con passaggi, stakeholder, strumenti, tempistiche e un punteggio di completezza.
- Fase 1 · Riordino: l'agente incaricato del riordino elabora la chat trasformandola in una narrazione cronologica, eliminando convenevoli e metalinguaggio. L'output consiste in un testo lineare e pulito, pronto per un'analisi deterministica nella fase successiva.
- Fase 2 · Estrazione: L'Agente di Estrazione produce dati strutturati: nome del processo, descrizione, passaggi in ordine cronologico, parti interessate (nome, ruolo, canale di contatto, tempistiche), strumenti impiegati e tempistica globale.
- Fase 3 · Validazione: il Validation Agent calcola un punteggio di completezza da 0 a 1 e segnala solo le lacune critiche (stakeholder esterni, strumenti critici, tempistiche dei passaggi ad alto impatto). Sotto 0,75, l'intervista viene contrassegnata per un follow-up.
- Filtraggio intelligente dei disturbi: strumenti come “discuss” o “review” non vengono segnalati. I contatti interni al team non vengono segnalati. Emergono solo le lacune sostanziali.
- Pista di controllo: ogni richiamo LLM viene registrato (modello, prompt, risposta, token) per le necessarie verifiche di conformità.
Quando due esperti documentano il medesimo processo, il sistema provvede a conciliarli.
Quando due o più esperti hanno documentato processi nello stesso contesto, si attiva automaticamente un agente di confronto semantico. Identifica passaggi condivisi, contributi univoci e conflitti, poi instrada il risultato attraverso una logica decisionale a tre fasce.
- Similarità > 0,95: genera una richiesta di approvazione manageriale. Il merge non è mai automatico: il creatore della campagna riceve un report con i passaggi condivisi/univoci e le motivazioni dell'agente. Il manager può approvare l'unione in un processo condiviso o mantenere le versioni separate.
- Similarità 0,4–0,95: contrassegnato come corrispondenza parziale. Entrambi i processi coesistono; il contesto viene etichettato per una revisione progressiva.
- Similarità < 0,4: segnalato per una verifica manuale. Molto probabilmente i due esperti stanno descrivendo processi distinti che si sono trovati a condividere la medesima etichetta di competenza.
- Ragionamento con nomi reali: il report di confronto usa i nomi reali degli esperti (“il passaggio di escalation di Marco”, non “Esperto 1”), rendendo le decisioni leggibili lungo tutta la catena manageriale.
- Emersione dei conflitti: quando i passaggi si contraddicono (Marco dice “escalation via Slack”, Sofia dice “via email”), l'agente segnala il conflitto invece di sceglierne uno in silenzio.
- CONDIVISO Contattare il reperibile secondario tramite PagerDuty qualora il principale non confermi la ricezione entro 5 minuti
- MARCO Escalation diretta all'EM tramite il canale Slack #incident-eng, non via email
- CONDIVISO Confermare la presa in carico su StatusPage entro 10 minuti dal rilevamento
- SOFIA Aprire il canale #cust-XYZ-incident per i clienti enterprise
Una knowledge base ricercabile, con un pulsante di annullamento su ogni decisione.
Il risultato è una knowledge base di processi documentati: ricercabile, filtrabile, con drill-down su narrazione cronologica + stakeholder + strumenti + tempistiche. Ogni operazione è un soft-delete: l'audit trail sopravvive a ogni merge, ogni annullamento, ogni aggiornamento.
- DataTables lato server: ricerca e filtraggio ultra-rapidi, operativi anche su migliaia di processi documentati. Possibilità di espandere la singola riga per accedere all'intero dettaglio del processo.
- Punteggio di completezza in evidenza per singolo processo: Punteggio 0–1 dalla validazione di Fase 3, con l'elenco delle informazioni mancanti. Le lacune di conoscenza sono esplicite, non nascoste.
- Unioni annullabili: un'unione approvata da un manager può essere annullata con un solo clic. I processi originari tornano attivi, quello condiviso passa in archivio e l'audit trail viene salvaguardato su entrambi i fronti.
- Cancellazione logica per tutti i dati: i dati archiviati restano interrogabili per finalità di audit (Articolo 30 del GDPR, evidenze ISO 27001). Il ripristino è un cambio di stato, non un recupero da backup.
- Modello di accesso a tre livelli: Owner / App Manager / Campaign Creator vedono l'intera pipeline; gli utenti standard vedono solo la propria panoramica e le azioni in sospeso (validazioni, interviste agli esperti, approvazioni).
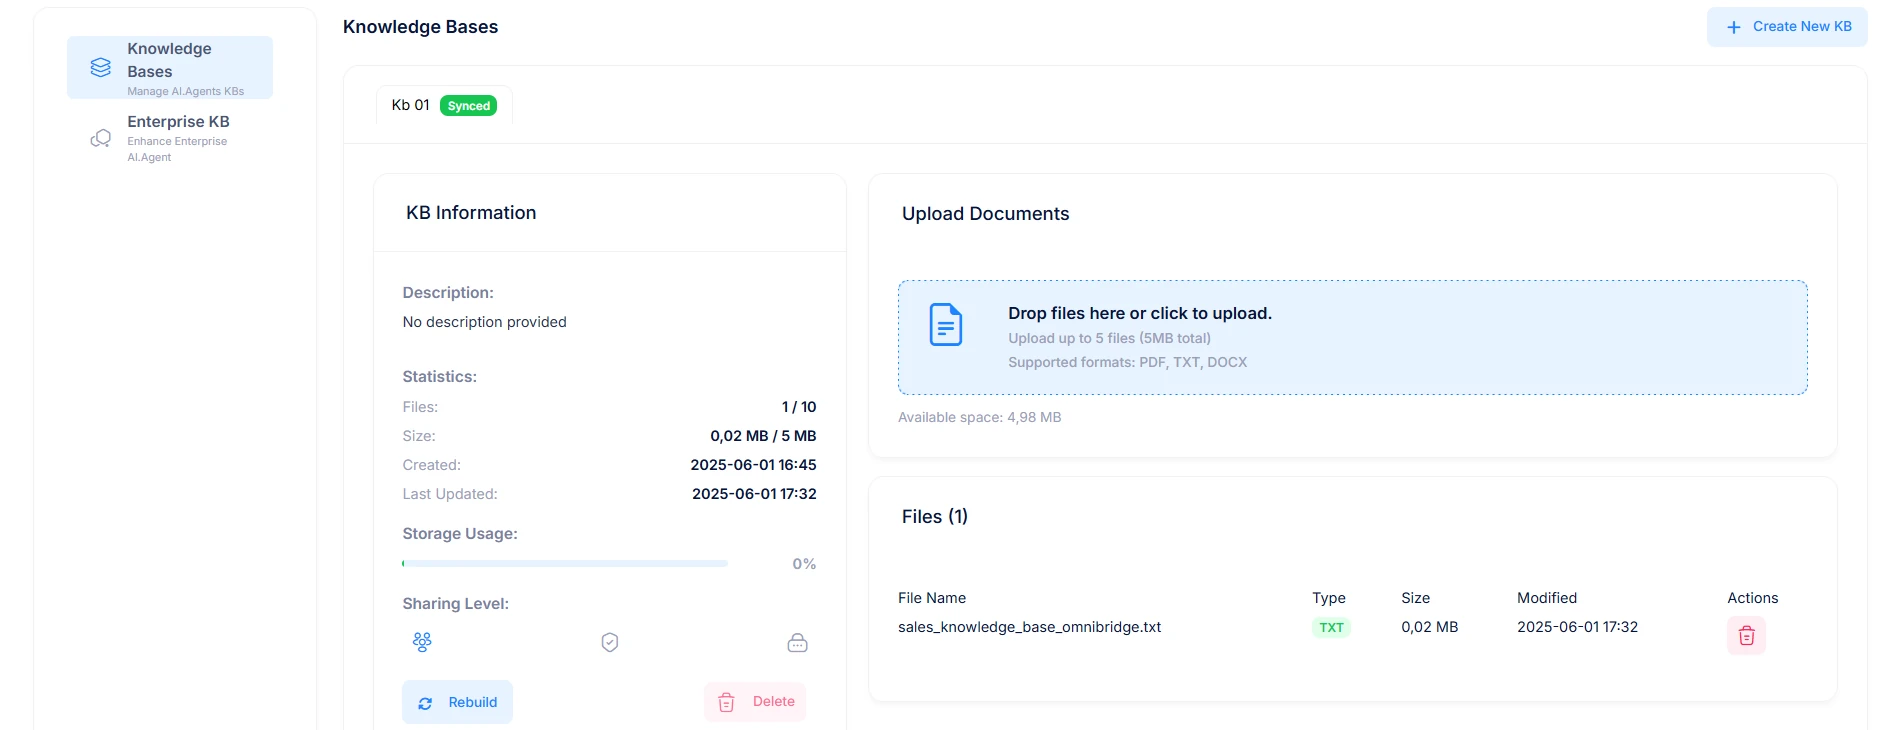
La conoscenza acquisita alimenta ciascun agente operativo sulla piattaforma.
Il Knowledge Mapping è la fonte, non la destinazione. La knowledge base validata, documentata e deduplicata diventa il substrato di retrieval per il resto della piattaforma: chatbot, agenti di onboarding, analisti strategici.
- Gli Assistenti Chatbot fanno puntualmente riferimento all'intervista specialistica originale dalla quale hanno estrapolato la risposta.
- Gli agenti di onboarding rispondono alle domande dei nuovi assunti da processi validati, non da FAQ generiche.
- I passaggi di consegne interni danno al nuovo responsabile un brief strutturato, non un link a Loom.
- Visibilità su base need-to-know per ogni asset. Ogni asset acquisito porta con sé un ambito di riservatezza (unità organizzativa, progetto o privato all'autore), così il recupero resta limitato a chi è autorizzato a vederlo.
- Diritto alla cancellazione rispettato a livello di esperto: una richiesta di cancellazione applica un soft-delete ai contributi; il processo unificato resta, ma i contributi identificabili dell'esperto vengono rimossi dall'audit trail e l'evento di cancellazione viene registrato.
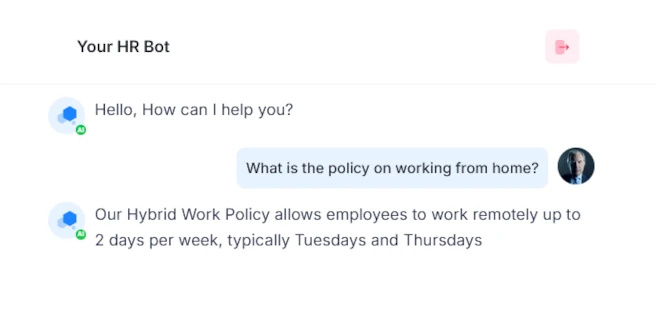
In quali contesti si manifestano i benefici della mappatura della conoscenza.
- Conservazione della Conoscenza Fondamentale
- Criticità legate a Pensionamenti e Successioni
- Recupero delle Conoscenze dell'Epoca Fondativa
- Esame dei Singoli Punti di Vulnerabilità (Single-Point-of-Failure)
- Affidabilità Operativa
- Uniformazione dei Processi (su più Sedi)
- Individuazione delle Migliori Prassi (Best Practice)
- Allineamento delle Varianti tra i Team
- Knowledge integration in operazioni M&A
- Manuale Operativo per l'Escalation dei Clienti
- Base di Conoscenza per l'Inserimento dei Neoassunti (Onboarding KB)
- Protocollo Operativo per la Gestione degli Incidenti
- Iniziative Strutturate di Mentoring
- Apprendimento Critico dai Progetti Infruttuosi
- Iter di Aggiornamento Trimestrale
