Mapear el conocimiento experto.
Luego capture lo que sabe.
Red de competencias validada por pares + entrevistas AI a expertos + pipeline de extracción en tres fases + comparación semántica entre expertos. Knowledge Mapping es la capa de memoria institucional que captura quién sabe qué y cómo lo hace realmente, y lo reconcilia a nivel organizativo, con cada decisión reversible.
Quién sabe qué, validado antes de empezar a documentar.
El sistema arranca desde el mapa de competencias, no desde el documento. Auto-declaraciones y nominaciones del manager fluyen a través de una red de validación entre pares con cuatro veredictos. Solo las competencias validadas activan una entrevista con el experto.
- Validación con cinco veredictos: Confirmado · En desacuerdo · No lo conozco · “Anche Io” (yo también lo tengo) · “Shared Others” (nominar a un colega). La forma de la red mapea la experiencia compartida sin necesidad de una encuesta.
- Promoción basada en umbral: candidato → experiencia validada solo tras confirmaciones configurables. No se desperdicia ninguna entrevista con experto en una declaración rechazada por los pares.
- Polinización cruzada vía Anche Io: cuando un par señala que también tiene la competencia, el sistema lanza una entrevista paralela con el experto y captura variantes del mismo proceso desde múltiples fuentes.
- Distribución consciente del scope: las solicitudes de validación se enrutan por elemento organizativo, proyecto o ámbito global; los pares se eligen por proximidad de expertise, no por proximidad de organigrama.
Expertise tácita extraída por una AI conversacional, sin formularios que rellenar.
Una vez validada una competencia, el sistema invita al experto a un chat adaptativo. El agente de entrevista decide qué indagar y cuándo el proceso ha quedado capturado con todos los detalles críticos, sin longitud fija ni guion fijo.
- Preguntas adaptativas: el agente lee cada respuesta y elige la siguiente pregunta, indagando en los detalles (nombres, canales, timing) allí donde la respuesta es vaga.
- Detección de finalización: el agente decide cuándo el proceso reúne los pasos, stakeholders, herramientas y timing necesarios para la extracción posterior, y no antes.
- Streaming en tiempo real: sesión basada en SSE, historial completo de conversación persistido, recuperable entre sesiones.
- Consciente del contexto: el agente recibe el rol del experto, la organización, el proyecto y el contexto de la competencia, no parte de cero.
- Captura multilingüe: entrevistas con expertos en el idioma preferido del contributor; la recuperación downstream funciona entre idiomas.
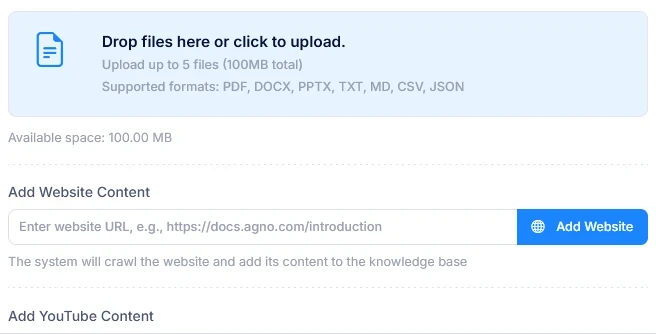
Tres fases. Conversación de entrada, conocimiento estructurado de salida.
Cada entrevista completada recorre tres agentes LLM especializados en secuencia, orquestados como tareas de Celery para que la UI nunca se bloquee. El resultado es un Proceso estructurado con pasos, stakeholders, herramientas, timing y un completeness score.
- Fase 1 · Reordenación: el Reordering Agent reescribe el chat como narrativa cronológica, eliminando chitchat y meta-conversación. Output: un texto lineal limpio que la fase siguiente puede parsear de forma determinista.
- Fase 2 · Extracción: el Extraction Agent emite datos estructurados: nombre del proceso, descripción, pasos ordenados, stakeholders (nombre, rol, canal de contacto, timing), herramientas, timeline global.
- Fase 3 · Validación: el Validation Agent calcula un completeness score de 0–1 y señala solo los gaps críticos (stakeholders externos, herramientas críticas, timing de los pasos de alto impacto). Por debajo de 0,75, la entrevista se marca para follow-up.
- Filtrado inteligente de ruido: herramientas como “discuss” o “review” no se marcan. Los contactos internos del team no se marcan. Solo afloran las brechas materiales.
- Audit trail: cada llamada LLM se registra (modelo, prompt, respuesta, tokens) para revisión de cumplimiento.
Cuando dos expertos documentan el mismo proceso, el sistema los reconcilia.
Una vez que dos o más expertos han documentado procesos en el mismo contexto, un agente de comparación semántica se ejecuta automáticamente. Identifica pasos compartidos, contribuciones únicas y conflictos, y luego enruta el resultado a través de una lógica de decisión de tres bandas.
- Similitud > 0,95: crea una solicitud de Manager Approval. Un merge nunca es automático; la comparación va al creador de la campaña con los pasos compartidos / únicos y el razonamiento del agente. El manager aprueba la fusión en un proceso compartido o los mantiene separados.
- Similitud 0,4–0,95: marcada como coincidencia parcial. Ambos procesos coexisten; el contexto queda etiquetado para revisión incremental.
- Similitud < 0,4: marcada para revisión humana. Los dos expertos probablemente describen procesos distintos que coincidieron en compartir una etiqueta de competencia.
- Razonamiento con nombres reales: el informe comparativo usa los nombres reales de los expertos (“el paso de escalation de Marco”, no “Experto 1”), de modo que las decisiones se leen con claridad a lo largo de toda la cadena de mando.
- Visibilización de conflictos: cuando los pasos se contradicen (Marco dice “escalar por Slack”, Sofia dice “por email”), el AI agent señala el conflicto en lugar de elegir uno en silencio.
- COMPARTIDO Contactar al on-call secundario vía PagerDuty si el primario no acepta en 5 min
- MARCO Escalar al EM directamente por el Slack #incident-eng, no por email
- COMPARTIDO Acknowledge en StatusPage en los 10 min posteriores a la detección
- SOFIA Abrir el canal #cust-XYZ-incident para clientes de tier enterprise
Una knowledge base con búsqueda y un botón de deshacer en cada decisión.
El resultado es una knowledge base de procesos documentados, con búsqueda, filtrable y con drill-down hasta narrativa cronológica + stakeholders + herramientas + timing. Toda operación es soft-delete: el audit trail sobrevive a cada merge, a cada undo y a cada refresh.
- DataTables server-side: búsqueda y filtrado rápidos incluso con miles de procesos documentados. Drill desde la fila hasta el detalle completo del proceso.
- Completeness Score visible por proceso: puntuación 0–1 de la validación de Fase 3, con la lista de información faltante. Los gaps de conocimiento son explícitos, no quedan ocultos.
- Merges reversibles: una fusión aprobada por el manager puede deshacerse en un clic. Procesos originales restaurados, proceso compartido archivado, audit trail preservado en ambos lados.
- Soft delete en todo: los datos archivados siguen siendo consultables para auditoría (RGPD Artículo 30, evidencia ISO 27001). El restore es un cambio de estado, no una recuperación de backup.
- Modelo de acceso de tres niveles: Owner / App Manager / Campaign Creator ven el pipeline completo; los usuarios normales solo ven su overview y sus acciones pendientes (validaciones, entrevistas con expertos, aprobaciones).
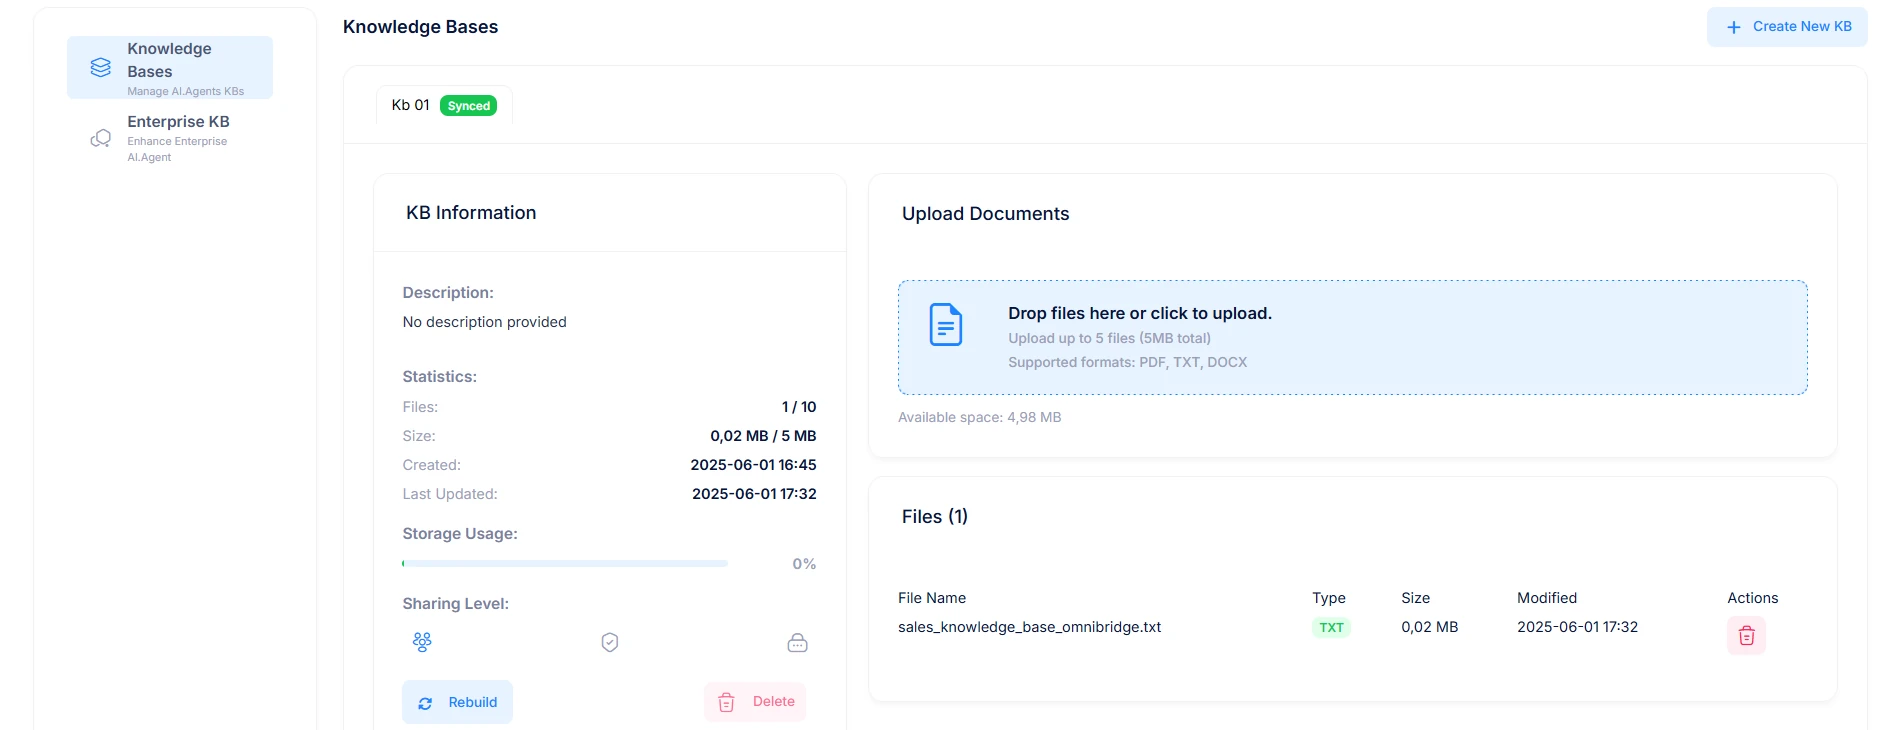
El conocimiento capturado alimenta a cada agente de la plataforma.
Knowledge Mapping es la fuente, no el destino. La knowledge base validada, documentada y deduplicada se convierte en el sustrato de recuperación para el resto de la plataforma: chatbots, agentes de onboarding, analistas estratégicos.
- Los Chatbot Assistants citan de vuelta la entrevista original con el experto que capturó la respuesta.
- Los agentes de onboarding responden a las nuevas incorporaciones desde procesos validados, no desde FAQs genéricas.
- Los handovers internos entregan un brief estructurado al owner entrante, no un enlace de Loom.
- Alcance basado en la necesidad de saber en cada activo. Cada activo capturado lleva un alcance de confidencialidad (unidad de la organización, proyecto o privado para el autor), de modo que la consulta se limita a quien está autorizado a verlo.
- Derecho de supresión respetado a nivel de experto: una solicitud de borrado soft-elimina las contribuciones; el proceso fusionado permanece, con las contribuciones identificables del experto retiradas del trail, y el evento de supresión queda registrado.
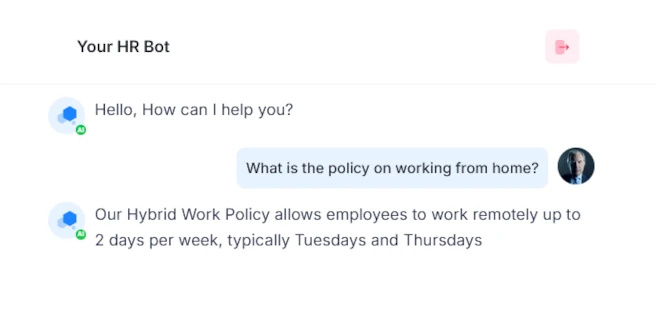
Dónde rentabiliza el knowledge mapping.
- Preservación de conocimiento crítico
- Riesgo de jubilación y sucesión
- Captura de conocimiento de la era fundadora
- Auditoría de single-point-of-failure
- Resiliencia operativa
- Estandarización de procesos (multi-site)
- Identificación de best practices
- Reconciliación de variantes entre equipos
- Integración de conocimiento en M&A
- Playbook de escalada de cliente
- KB de onboarding de nuevos hires
- Runbook de respuesta a incidentes
- Programas de mentoring estructurados
- Lecciones de proyectos fallidos
- Ciclo de refresh trimestral
