Cartographiez l'expertise.
Puis capturez ce qu'elle sait.
Réseau de compétences validé par les pairs + entretiens d'experts AI + pipeline d'extraction en trois phases + comparaison sémantique entre experts. Knowledge Mapping est la couche de mémoire institutionnelle qui capture qui sait quoi, comment chacun procède réellement, et réconcilie l'ensemble à l'échelle de l'organisation, chaque décision restant réversible.
Qui sait quoi, validé avant même de commencer à documenter.
Le système part de la carte des compétences, pas du document. Les auto-déclarations et les nominations manager passent par un réseau de validation par les pairs à quatre verdicts. Seules les compétences validées déclenchent un entretien d'expert.
- Validation à cinq verdicts: Confirmé · Pas d'accord · Ne connaît pas · “Anche Io” (je l'ai aussi) · “Shared Others” (nommer un collègue). La structure du réseau cartographie l'expertise partagée sans nécessiter d'enquête.
- Promotion par seuil: candidat → expérience validée uniquement après un nombre configurable de confirmations. Aucun entretien d'expert gaspillé sur une déclaration rejetée par les pairs.
- Pollinisation croisée via Anche Io: quand un pair signale qu'il possède lui aussi la compétence, le système déclenche un entretien d'expert parallèle, captant ainsi les variantes d'un même processus auprès de plusieurs sources.
- Distribution sensible au périmètre: requêtes de validation acheminées par élément organisationnel, projet ou périmètre global ; les pairs sont choisis pour leur proximité d'expertise, non pour leur proximité dans l'organigramme.
L'expertise tacite extraite par une AI conversationnelle, sans aucun formulaire à remplir.
Une fois la compétence validée, le système invite l'expert à un échange conversationnel adaptatif. L'agent d'entretien décide quoi approfondir et à quel moment le processus a été capturé avec tous ses détails critiques, sans durée fixe ni script figé.
- Questionnement adaptatif: l'agent lit chaque réponse et choisit la question suivante, approfondissant les détails précis (noms, canaux, timing) là où la réponse reste vague.
- Détection de complétude: l'agent décide quand le processus réunit les étapes, parties prenantes, outils et timing nécessaires à l'extraction en aval, et pas avant.
- Streaming temps réel: session basée SSE, historique de conversation persisté, récupérable entre sessions.
- Sensible au contexte: l'agent reçoit le rôle de l'expert, l'organisation, le projet et le contexte de la compétence, plutôt qu'une page blanche.
- Capture multilingue: entretiens d'experts dans la langue préférée du contributeur ; la recherche en aval fonctionne à travers les langues.
Trois phases. Conversation en entrée, savoir structuré en sortie.
Chaque entretien terminé passe par trois agents LLM spécialisés en séquence, orchestrés sous forme de tâches Celery pour que l'interface ne bloque jamais. Le résultat est un Process structuré comprenant étapes, parties prenantes, outils, timing et un score de complétude.
- Phase 1 · Réordonnancement: le Reordering Agent réécrit le chat en récit chronologique, en éliminant les digressions et le méta-discours. Sortie : un texte linéaire propre que la phase suivante peut parser de façon déterministe.
- Phase 2 · Extraction: l'Extraction Agent émet des données structurées : nom du processus, description, étapes ordonnées, parties prenantes (nom, rôle, canal de contact, timing), outils, calendrier global.
- Phase 3 · Validation: le Validation Agent calcule un score de complétude compris entre 0 et 1 et ne signale que les manques critiques (parties prenantes externes, outils critiques, timing des étapes à fort impact). En dessous de 0,75, l'entretien est signalé pour suivi.
- Filtrage intelligent du bruit: les outils comme “discuss” ou “review” ne sont pas signalés. Les contacts internes à l'équipe ne sont pas signalés. Seuls les écarts significatifs remontent.
- Piste d'audit: chaque appel LLM est journalisé (modèle, prompt, réponse, tokens) pour la revue compliance.
Quand deux experts documentent le même processus, le système les réconcilie.
Dès que deux experts ou plus ont documenté des processus dans le même contexte, un agent de comparaison sémantique s'exécute automatiquement. Il identifie les étapes communes, les contributions uniques et les conflits, puis achemine le résultat selon une logique de décision à trois paliers.
- Similarité > 0,95: crée une demande de Manager Approval. Une fusion n'est jamais automatique ; la comparaison est transmise au créateur de la campagne avec les étapes communes / uniques et le raisonnement de l'agent. Le manager approuve la fusion en processus partagé, ou les maintient séparés.
- Similarité 0,4–0,95: marquée comme correspondance partielle. Les deux processus coexistent ; le contexte est étiqueté pour revue incrémentale.
- Similarité < 0,4: signalée pour revue humaine. Les deux experts décrivent probablement des processus différents qui partagent par hasard la même étiquette de compétence.
- Raisonnement avec noms réels: le rapport comparatif utilise les noms réels des experts (“l'étape d'escalation de Marco”, et non “Expert 1”), ce qui rend les décisions lisibles à tous les niveaux de la chaîne managériale.
- Exposition des conflits: lorsque les étapes se contredisent (Marco dit “faire l'escalation via Slack”, Sofia dit “par e-mail”), l'AI agent signale le conflit au lieu d'en retenir une en silence.
- PARTAGÉ Alerter le secondaire d'astreinte via PagerDuty si le primaire n'accuse pas réception en 5 min
- MARCO Escalader directement à l'EM via Slack #incident-eng, pas par email
- PARTAGÉ Accuser réception dans StatusPage dans les 10 min après détection
- SOFIA Ouvrir un canal #cust-XYZ-incident pour les clients enterprise-tier
Une knowledge base interrogeable, avec un bouton d'annulation sur chaque décision.
Le résultat est une knowledge base de processus documentés : interrogeable, filtrable, avec exploration détaillée vers le récit chronologique + parties prenantes + outils + timing. Toutes les opérations sont en soft-delete : la piste d'audit survit à chaque fusion, chaque annulation, chaque rafraîchissement.
- DataTables côté serveur: recherche et filtrage rapides même sur des milliers de processus documentés. Drill-down depuis la ligne vers le détail complet du processus.
- Completeness Score visible par processus: Score entre 0 et 1 issu de la validation de Phase 3, avec la liste des informations manquantes. Les gaps de connaissance sont explicites, pas cachés.
- Fusions réversibles: une fusion approuvée par le manager peut être annulée en un clic. Processus originaux restaurés, processus partagé archivé, piste d'audit préservée des deux côtés.
- Soft delete sur tout: les données archivées restent interrogeables pour l'audit (RGPD Article 30, preuve ISO 27001). La restauration est un changement d'état, pas une récupération depuis sauvegarde.
- Modèle d'accès à trois niveaux: Owner / App Manager / Campaign Creator voient le pipeline complet ; les utilisateurs standard ne voient que leur Overview et leurs actions en attente (validations, entretiens d'experts, approbations).
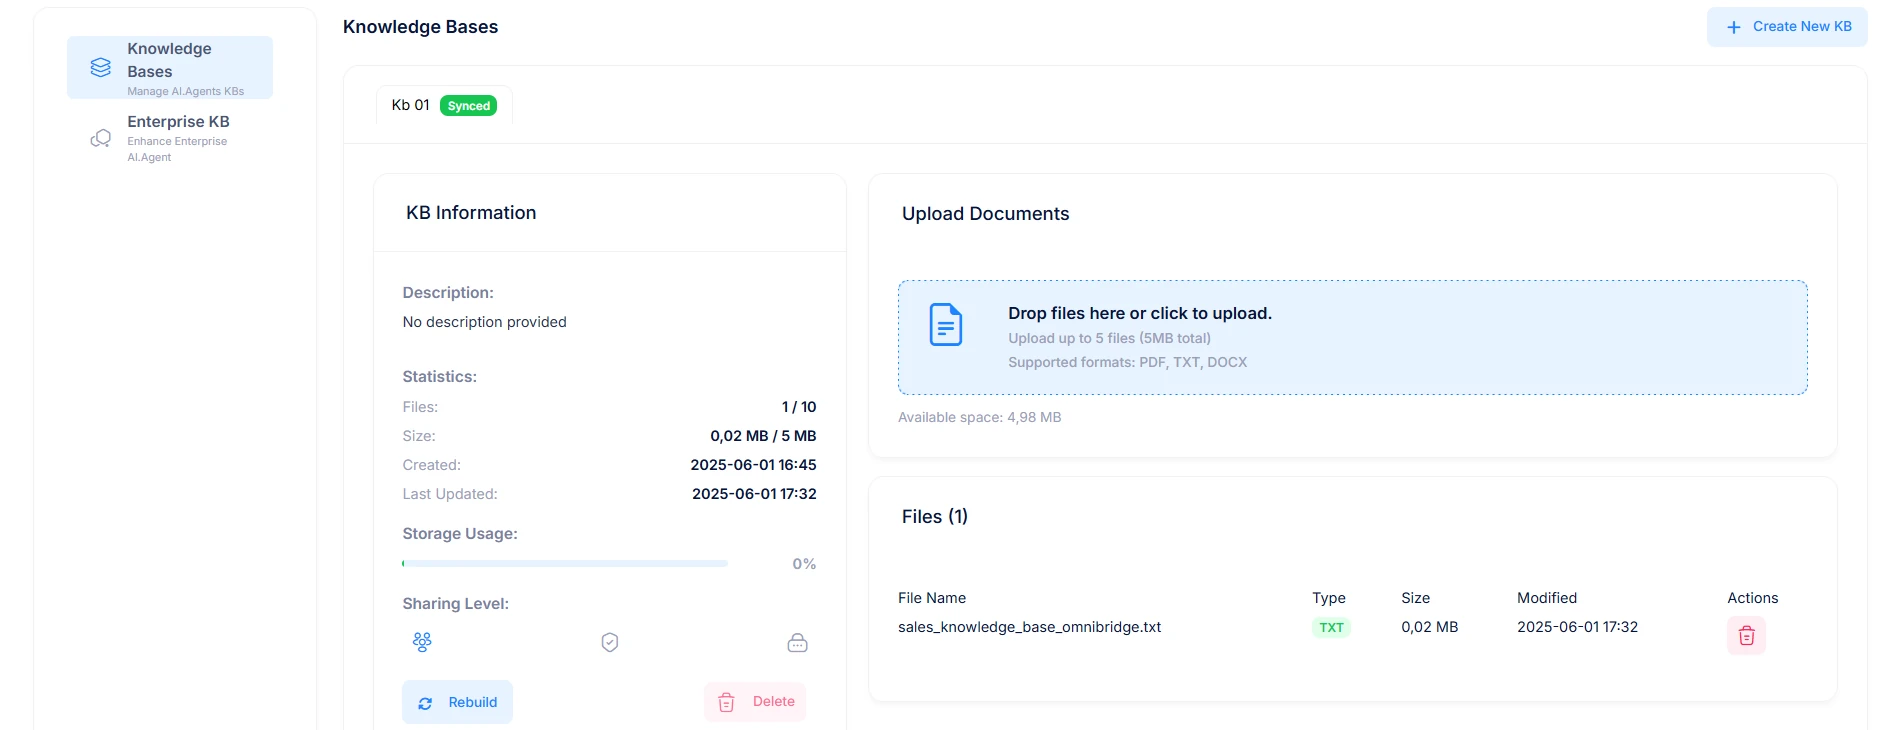
Le savoir capturé alimente chaque agent de la plateforme.
Knowledge Mapping est la source, pas la destination. La base de connaissances validée, documentée et dédupliquée devient le substrat de récupération pour le reste de la plateforme : chatbots, agents d'onboarding, analystes stratégiques.
- Les Chatbot Assistants citent en référence l'entretien d'expert d'origine qui a capturé la réponse.
- Les agents d'onboarding répondent aux questions des nouvelles recrues à partir de processus validés plutôt que de FAQ génériques.
- Les passations internes transmettent un brief structuré au nouveau responsable, et non un lien Loom.
- Une portée « besoin d'en connaître » sur chaque asset. Chaque asset capturé porte une portée de confidentialité (unité de l'organisation, projet, ou privé à l'auteur), de sorte que la consultation se limite aux personnes habilitées à le voir.
- Droit à la suppression honoré au niveau de l'expert : une demande d'effacement applique un soft-delete aux contributions ; le processus fusionné subsiste, les contributions identifiables de l'expert sont retirées de la piste d'audit, et l'événement d'effacement est consigné.
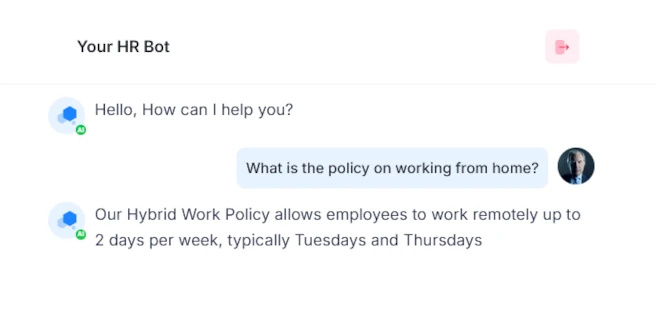
Là où la cartographie des connaissances paie.
- Préservation des connaissances critiques
- Risque de départ à la retraite et de succession
- Capture du savoir de l'ère des fondateurs
- Audit des points de défaillance uniques
- Résilience opérationnelle
- Standardisation des processus (multi-sites)
- Identification des meilleures pratiques
- Réconciliation des variantes entre équipes
- Intégration des connaissances M&A
- Playbook d'escalade client
- Knowledge base d'onboarding
- Runbook de gestion des incidents
- Programmes de mentorat structurés
- Enseignements des projets échoués
- Cycle de rafraîchissement trimestriel
