Les conversations
que votre organisation n'a pas.
Sept entreprises américaines sur dix mènent des entretiens de départ — seul un dirigeant sur quatre fait confiance aux données qu'elles collectent (Spain & Groysberg, Harvard Business Review, 2016). La contrainte est opérationnelle : un interviewer formé qui sonde de manière cohérente coûte cher et reste rare. KS-Agents conduit l'entretien lui-même — adaptatif en temps réel, structuré en sortie, reproductible à chaque transition.
L'entretien structuré, enfin à l'échelle des effectifs.
Les entretiens structurés prédisent les résultats au travail plus de deux fois mieux que les entretiens non structurés (Sackett, Zhang, Berry & Lievens, Journal of Applied Psychology, 2022). La discipline est bien connue. La raison pour laquelle elle reste sous-appliquée : la conduire de manière cohérente exige un interviewer formé à chaque conversation — une capacité qui n'existe pas à l'échelle organisationnelle.
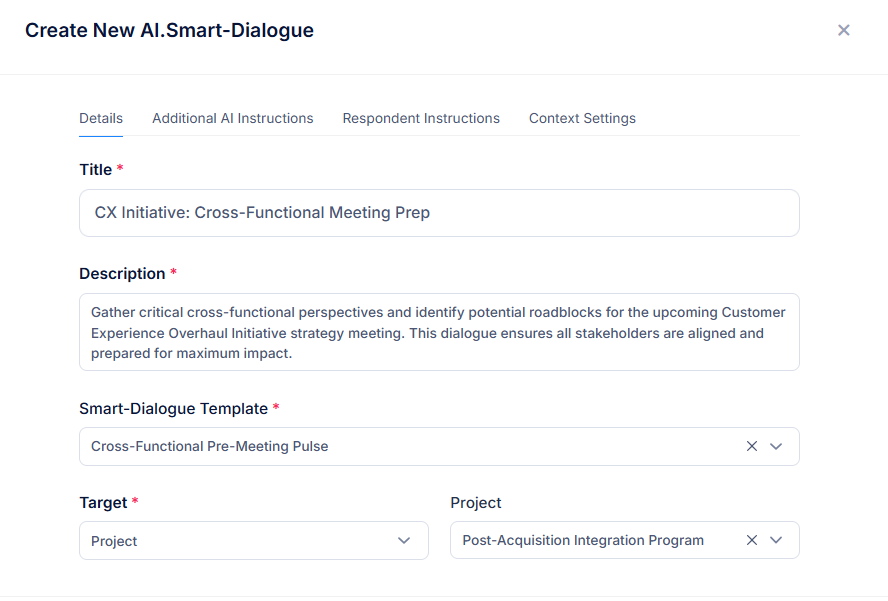
KS-Agents conduit l'entretien selon le modèle que vous définissez :
- Définissez une fois l'objectif, le ton, le périmètre et les règles de relance. Le modèle est réutilisé entre cohortes sans dérive.
- Chaque relance est générée à partir de la réponse réelle du participant — la discipline de probing reste constante sur chaque entretien du programme.
- Knowledge base attachée au niveau du modèle : l'agent raisonne sur vos policies, vos décisions antérieures et le contexte projet pendant la conversation.
- Les guardrails, le comportement de refus et les limites de divulgation sont configurables par modèle — et visibles dans l'audit.
La connaissance tacite n'émerge que quand on sonde la réponse vague.
Ce que les collaborateurs expérimentés savent sans pouvoir l'articuler facilement — le paradoxe de Polanyi, contrainte structurelle du transfert de connaissances routinier (Autor, NBER Working Paper 20485, 2014) — échappe aux formulaires statiques. Le passage du tacite à l'explicite exige toujours une question supplémentaire, calibrée sur la réponse précédente.
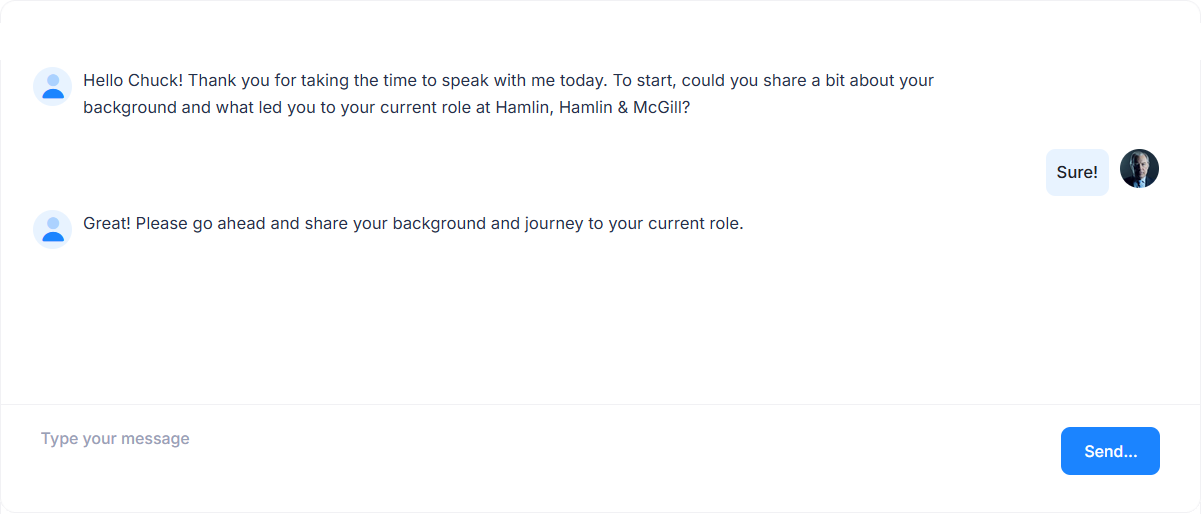
L'agent prend cette décision en temps réel :
- Repère les réponses génériques (« l'équipe va bien ») et demande le moment, la décision ou la personne précise qui se cache derrière.
- Signale les contradictions avec les réponses précédentes dans la même session — sans confronter le participant.
- Raisonne avec le contexte organisationnel : structure, rôle, ancienneté, interactions antérieures.
- Croise les insights agrégés et anonymisés des entretiens des pairs quand le signal le justifie.
- Déclenche des alertes de critical response dès qu'un élément requiert une attention humaine — signaux de détresse, problèmes d'intégrité, contenu réglementé.
Des briefs que l'équipe dirigeante lit. Les transcriptions disponibles si la forensique l'exige.
Spain & Groysberg attribuent le déficit de crédibilité des entretiens de départ précisément à l'échec de synthèse : transcriptions brutes produites, aucun résumé actionnable restitué aux managers, aucune boucle de feedback. Données utiles surproduites et sous-décidées.
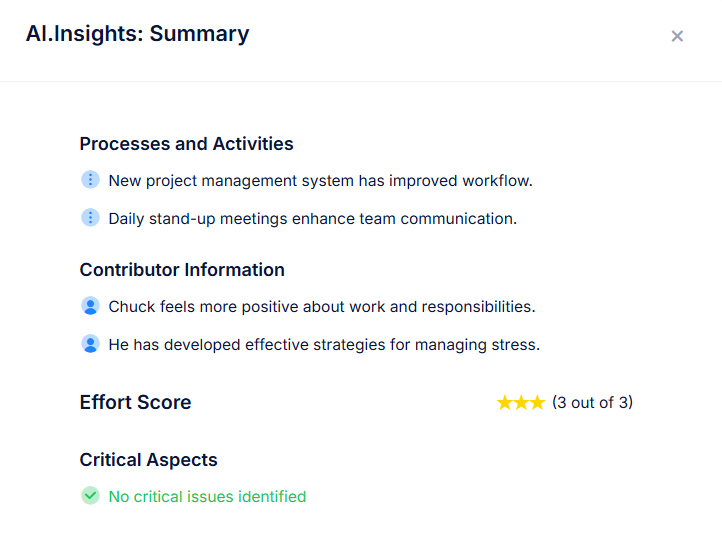
Chaque session se clôt en un deliverable structuré :
- Brief aligné sur les objectifs du modèle — ce qui a été demandé, ce qui a été appris, ce qui reste en suspens.
- Thèmes, classification de sentiment et citations directes illustratives préservant la voix du participant.
- Risk flags remontés pour revue humaine — jamais traités automatiquement.
- Agrégations de tendances entre cohortes, directions et fenêtres temporelles — patterns visibles uniquement lorsque l'écoute devient continue.
- Export en CSV, PDF, ou intégration dans l'analytique downstream. La transcription reste disponible pour revue lorsque la forensique l'exige.
Quand le coût marginal d'un entretien supplémentaire approche zéro.
Programmes typiquement opérés sur le moteur :
- Entretiens de départ
- Entretiens de fidélisation
- Points d'onboarding
- Sélection des candidats
- Évaluations de performance
- Leadership 360°
- Capture des connaissances expertes
- Rétrospectives projet
- Briefings pré-réunion
- Pulses de climat d'équipe
- Écoute en change management
- Approfondissements NPS
- Conformité & remontée d'incidents
- Screening bien-être & burnout
- Analyse des Besoins en Formation
- Customer discovery
- Pulses NPS interne & D&I
- Innovation & remontée d'idées